



지난 글에서는 Athena와 Trino가 같은 계보의 엔진이면서 운영 모델이 어떻게 다른지 살펴봤다. 이번 글은 Trino 안으로 들어가서 SQL 하나가 어떻게 잘게 나뉘어 여러 노드에서 실행되는지 다룬다.
클러스터 구성
Trino는 MPP(Massively Parallel Processing) 방식의 분산 쿼리 엔진이다. 서버 한 대의 사양을 키우는 대신 노드를 늘려 처리 능력을 늘린다.

구성 요소 | 역할 | 수 |
Coordinator | SQL을 받아 계획을 세우고 Worker에 일을 나눠줌. 최종 결과를 클라이언트에 전달 | 클러스터당 1대 |
Worker | 배정받은 Task를 실행. 데이터 소스를 읽고 중간 결과를 다른 Worker와 주고받음 | N대 |
•
클라이언트는 항상 Coordinator에 접속함
•
결과는 한 번에 오지 않음. 클라이언트가 읽어 가는 만큼 Coordinator가 Worker에서 다음 데이터를 가져와 쿼리가 끝날 때까지 흘려보냄
•
heartbeat가 끊긴 노드는 장애로 판단되어 새 Task를 받지 못함
•
노드 사이의 통신과 데이터 전송은 모두 HTTP로 이루어짐
쿼리 실행 모델
SQL이 실행 계획이 되기까지
Coordinator는 들어온 SQL을 파싱하고 분석한 뒤 논리 계획을 세우고 최적화한다.
1.
파싱 — SQL 문자열을 구문 트리로 바꿈
2.
분석 — 테이블과 컬럼이 존재하는지, 타입이 맞는지, 권한이 있는지 확인
3.
논리 계획 — 데이터를 어떤 연산 순서로 처리할지 담은 실행 계획 생성
4.
최적화 — 필터를 데이터 쪽으로 내리고 부분 집계를 넣고 조인 순서를 정함
5.
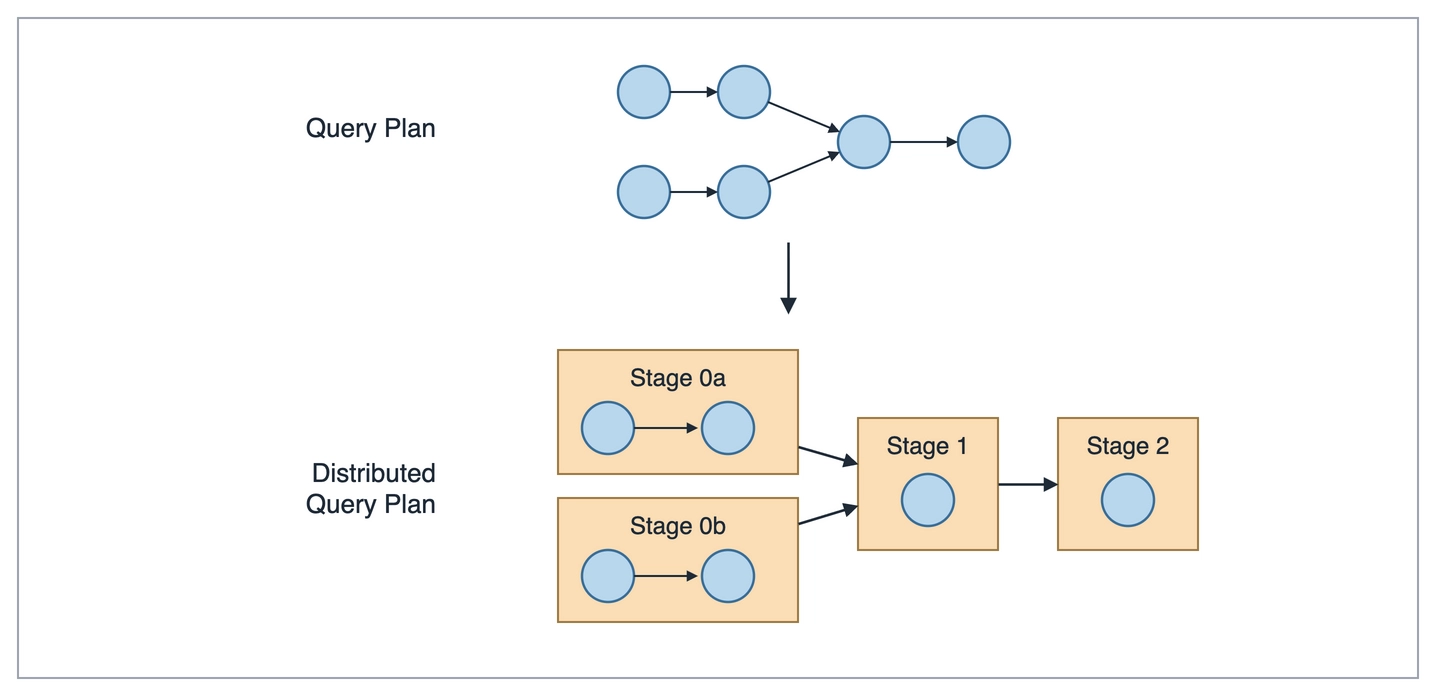
분산 계획 — 논리 계획을 여러 조각(Fragment)으로 나눠 클러스터에서 병렬로 실행할 수 있는 형태로 만듦
실행 단위
분산 계획은 여러 겹의 실행 단위로 나뉜다.
단위 | 정의 |
Stage | Fragment 하나가 실행될 때의 모습. 데이터를 다시 나눠야 하는 지점(셔플)마다 계획이 잘려 Stage가 생김 |
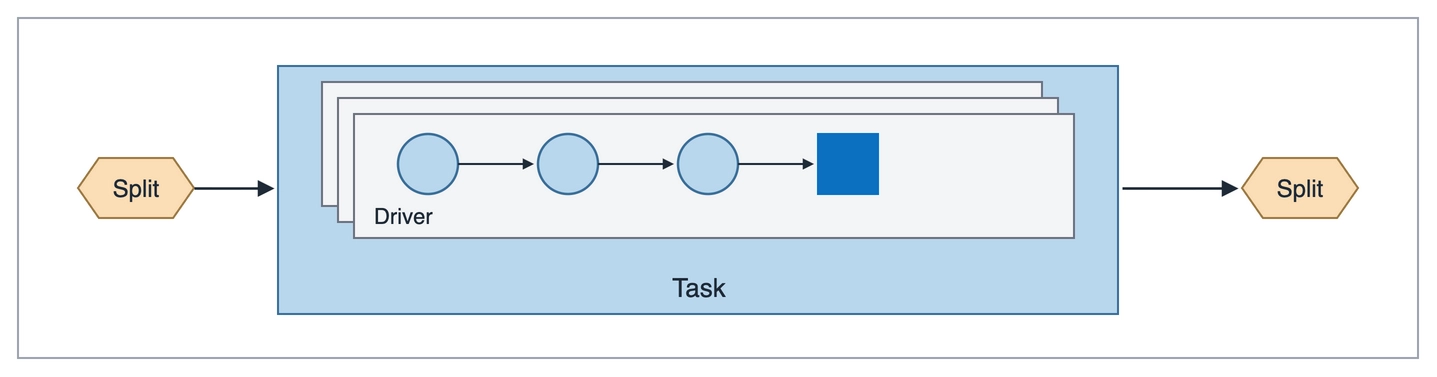
Task | Stage를 Worker 하나에 배정한 단위. Stage 하나는 여러 Worker에 걸쳐 Task 여러 개로 나뉨 |
Driver | Task 안에서 Pipeline 하나를 실행하는 인스턴스 |
Pipeline | Driver가 실행하는 Operator의 연속 (scan → filter → aggregate ...) |
Split | 어디를 읽을지 가리키는 설명서. 데이터 자체가 아님 |
Page | 실제로 흐르는 값. 여러 행을 컬럼 형태로 묶은 덩어리 |
이 중 실행 흐름을 이해하는 데 핵심인 것은 Stage, Split, 그리고 Stage 사이의 데이터 이동이다.
Stage

Coordinator가 Stage의 Task를 Worker에 배정
Stage는 쿼리 실행 계획의 한 단계다. 데이터를 다시 모으거나 나눠야 하는 지점마다 계획이 잘리고 잘린 조각 하나가 Stage 하나가 된다.
•
조인, GROUP BY, 정렬처럼 데이터를 다시 모아야 하는 연산이 많을수록 Stage도 늘어남
•
Stage는 서로 의존하는 트리를 이룸
•
맨 아래 Stage가 데이터 소스를 읽고(source stage) 위로 갈수록 앞 Stage의 결과를 받아 처리
•
맨 위 Stage가 최종 결과를 Coordinator에 넘김
Split
Split은 Task가 처리할 데이터 조각의 위치만 담는다. 예를 들어 Hive 커넥터의 Split은 파일 경로, 시작 위치, 길이로 파일의 일부 구간을 가리킨다.
•
쿼리가 시작되면 Coordinator가 커넥터에서 Split 목록을 받아 source stage의 Task들에 나눠줌
•
한꺼번에 다 보내지 않고 Worker가 처리를 끝내 자리가 나는 만큼 더 보냄. 그래서 빨리 처리하는 Worker가 더 많은 Split을 가져감
•
뒤 Stage의 Task에게는 앞 Stage Task의 output buffer 위치가 Split이 됨
Task는 받은 Split마다 Driver를 하나씩 만들고 Driver는 Operator를 차례로 거치며 Page를 다음으로 넘긴다. Pipeline의 마지막 Operator는 결과 Page를 Task의 output buffer에 넣는다.
Task 안에서 Split마다 병렬로 실행되는 Driver
Stage 사이의 데이터 이동
Stage 사이에서 데이터는 Page 단위로 이동한다.

Split으로 이어지는 Task 사이의 데이터 흐름
1.
앞 Stage의 Task는 결과 Page를 output buffer에 쌓음
2.
뒤 Stage의 Task는 Exchange Operator로 앞 Stage 모든 Task의 output buffer에서 자기 몫을 가져감
3.
데이터를 다시 나눠야 하면 앞 Stage는 output buffer를 받을 Task 수만큼 칸으로 나누고 행마다 키의 해시값으로 칸을 정함. 같은 키는 항상 같은 Task로 감
Worker 내부의 실행
Worker 하나 안에는 여러 쿼리, 여러 Stage의 Task와 Driver가 동시에 들어 있다. 이 Driver들을 실제로 실행하는 것은 Worker의 스레드 풀이다.
스레드와 Driver
개념 | 생성 시점 | 수 |
워커 스레드 | Worker 기동 시 미리 생성. 쿼리와 무관 | 고정. 기본값 CPU 수 × 2 |
Driver | Task가 Pipeline을 실행할 때 생성
(source stage에서는 Split 마다 하나) | 쿼리마다 다름. 보통 스레드 수보다 훨씬 많음 |
1.
스레드는 대기열에서 Driver를 하나 꺼내 짧은 시간 실행
2.
끝나지 않았으면 다시 대기열에 넣고 다음 Driver를 꺼냄
3.
오래 실행된 쿼리의 Driver는 우선순위가 점점 내려가 짧은 쿼리가 먼저 스레드를 받음
Spark의 Task는 executor 코어를 한 번 잡으면 끝날 때까지 놓지 않지만 Trino의 Driver는 짧게 실행하고 양보한다. 큰 작업 하나를 끝까지 처리하는 데 맞춘 Spark와 여러 쿼리를 동시에 공평하게 처리하는 데 맞춘 Trino의 설계 차이다.
Task 안의 병렬성
Task 안에서 Driver가 몇 개 생기는지는 Stage 성격에 따라 다르다.
1.
source stage: Split 하나당 Driver 하나. 쿼리 전체로 보면 Driver 수는 Split 수와 같고 Worker 수보다 훨씬 많다
2.
조인·집계 Stage: 받은 데이터를 Task 안에서 키 기준으로 한 번 더 나누고 정해진 수의 Driver가 병렬로 처리함. Worker 사이에서 한 번, Worker 안에서 한 번 나누는 이중 병렬 구조
설정 | 기본값 | 뜻 |
task.max-worker-threads | CPU 수 × 2 | Worker가 동시에 실제로 실행할 수 있는 Driver 수 |
task.concurrency | 노드의 물리 CPU 수(최소 2, 최대 32) | 조인·집계 Stage에서 Task 안에 만드는 Driver 수 |
node-scheduler.max-splits-per-node | 256 | Worker 하나가 동시에 맡을 수 있는 Split 수 |
exchange.client-threads | 25 | 앞 Stage Task의 Page를 가져오는 스레드 수 |
기본값은 Trino 버전에 따라 달라질 수 있음
실행 모드
파이프라인 실행
기본 모드에서는 Stage 사이 데이터가 디스크를 거치지 않고 메모리와 네트워크로 흐르고 대부분의 Stage가 함께 실행된다 (대화형 쿼리에 빠른 이유)
기본 스케줄링 정책(query.execution-policy=phased)은 조인처럼 Stage 사이에 순서가 필요한 경우 막히지 않도록 Stage를 단계적으로 띄움
연산 | 입력 받기 | 결과 내보내기 |
필터, 컬럼 계산, 부분 집계 | 오는 대로 | 오는 대로 |
최종 집계 (GROUP BY) | 오는 대로 해시 테이블에 누적 | 입력이 끝나야 |
정렬 (ORDER BY) | 오는 대로 쌓음 | 입력이 끝나야 |
이 방식에는 두 가지 약점이 있다.
1.
집계·조인 상태가 메모리에 다 올라가야 함. 넘치면 쿼리가 실패
2.
Worker 하나가 죽으면 그 Worker 메모리에 있던 중간 데이터가 사라져 쿼리 전체가 실패
Spark와 Trino
Trino의 파이프라인 실행을 Spark와 비교하면 다음과 같다.
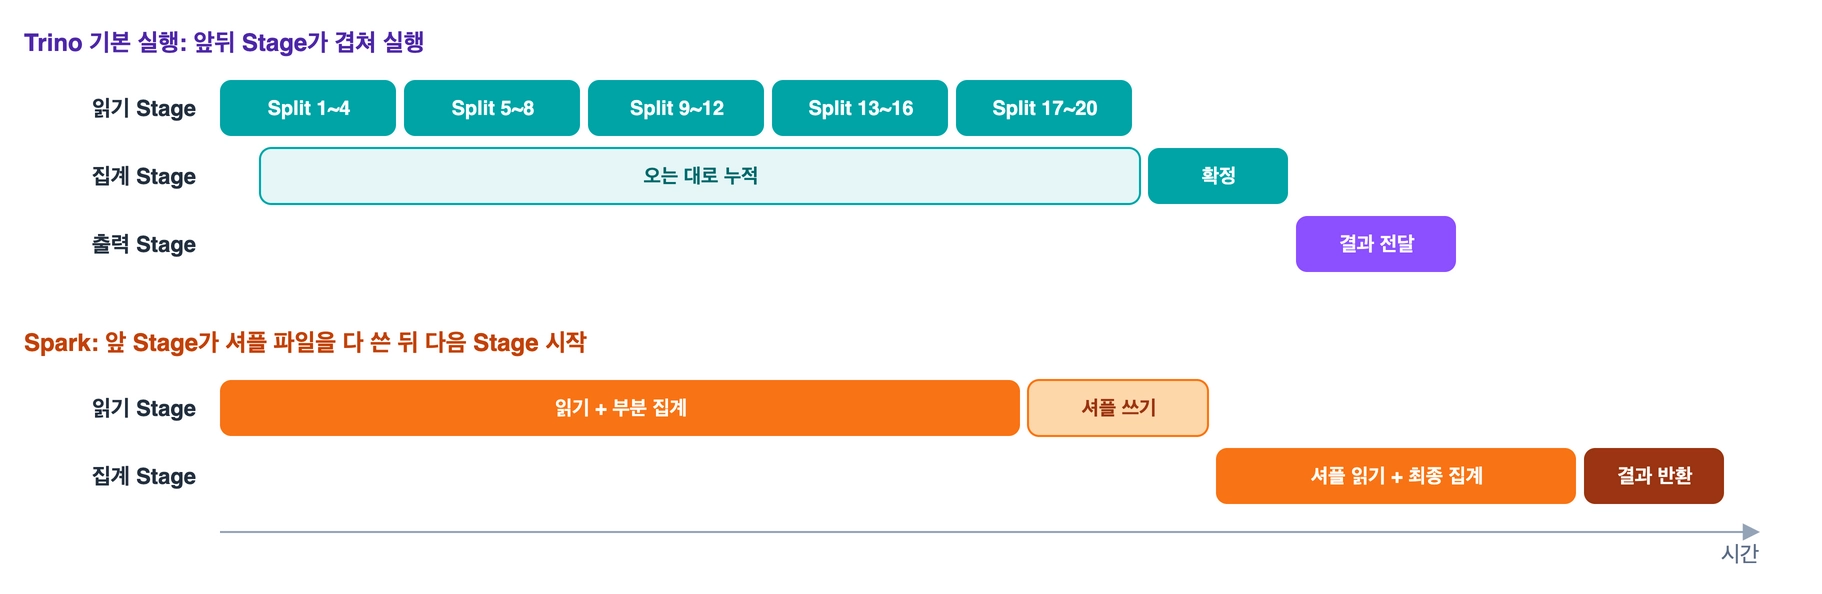
Spark는 앞 Stage가 셔플 파일을 디스크에 다 쓴 뒤에야 다음 Stage를 시작한다. Trino 기본 모드는 앞 Stage가 Page를 내보내는 동안 뒤 Stage가 바로 받아 처리하므로 두 Stage의 실행 시간이 겹친다. 기다리는 구간이 없어 전체 시간이 짧다.
Spark | Trino 파이프라인 실행 | |
Stage 사이 데이터 | 셔플 파일로 디스크에 씀 | 메모리와 네트워크로 바로 흘림 |
Stage 실행 순서 | 앞 Stage가 끝나야 다음 Stage 시작 | 앞뒤 Stage가 겹쳐 실행 |
노드 장애 | 실패한 Task만 다시 실행 | 쿼리 전체 실패 |
메모리보다 큰 데이터 | 디스크를 써서 처리 | spill을 켜지 않으면 실패 |
맞는 워크로드 | 대규모 배치 | 빠르게 결과를 내야 하는 ad-hoc 쿼리 |
디스크를 거치는 Spark는 느린 대신 실패와 큰 데이터에 강하고 메모리로 흘려보내는 Trino는 빠른지만 견고함은 떨어진다. Trino는 이 약점을 메우려고 Spark처럼 중간 데이터를 저장하는 모드도 제공한다.
장애 허용 실행
retry-policy=TASK로 장애 허용 실행을 켜면 Stage 사이 중간 데이터를 S3 같은 외부 저장소에 쓴다.
파이프라인 실행 | 장애 허용 실행 | |
Stage 실행 | 대부분 함께 실행, 메모리로 흐름 | 앞 Stage가 끝난 뒤 실행, 중간 데이터를 외부 저장소에 씀 |
Worker 장애 | 쿼리 전체 실패 | 실패한 Task만 재실행 |
속도 | 빠름 | 중간 데이터를 쓰고 읽는 만큼 느림 |
맞는 워크로드 | 대화형 조회 | 배치, 스팟 Worker |
여러 쿼리가 함께 실행될 때
Worker는 쿼리별로 나뉘지 않는다. Worker 5대에 쿼리 3개가 들어오면 세 쿼리 모두 5대 전부에 Task를 만들고 각 Worker 안에서 세 쿼리의 Driver가 스레드를 번갈아 쓴다.
자원 | 공유 방식 |
CPU | 스레드를 짧은 시간 단위로 번갈아 씀 |
메모리 | 클러스터 전체를 공유. 쿼리 하나가 쓸 수 있는 양은 query.max-memory, query.max-memory-per-node로 제한 |
동시 실행 수 | 기본은 제한 없음. Resource Group으로 그룹별 동시 실행 수와 메모리 비중을 정할 수 있음 |
정리
•
Trino 클러스터는 Coordinator 1대와 Worker N대로 이루어짐
•
Coordinator는 SQL을 분산 계획으로 만든 뒤 Stage → Task → Driver 순서로 잘게 나눠 Worker에 배정함
•
Split은 위치, Page는 값이고 Stage 사이에는 Page가 Exchange를 통해 흐름
•
재분배가 필요한 지점에서는 키의 해시로 output buffer를 나눠 같은 키가 항상 같은 Task로 가게 함
•
Worker의 스레드는 모든 쿼리의 Driver를 짧게 번갈아 실행하고 Worker는 쿼리끼리 나눠 갖지 않고 공유됨